人物画像的困境与突破
人物画像(personas)的创建门槛较低,却常常沦为摆设。这是Canoncial团队在用户研究方法论上的一次重要探索。我们打造了一套称为“原型(archetypes)”的系统,让多团队及其智能体都能共享机器可读的用户描述。本文聚焦于系统设计与架构,下一篇将介绍如何持续维护更新。
人物画像本应是实用的工具,但在现实中,它们往往变成演示文稿中的装饰性元素,在项目工作坊结束后便无人问津。核心挑战在于:如何确保这些画像始终保持使用、准确且与当下相关?
规模化带来的复杂性
在Canoncal,这一挑战因业务广度而更为突出。我们开发了超过60款技术产品,服务用户群体跨度极大——从拥有家庭服务器的爱好者,到管理庞大机器群的CTO。各团队对自身细分用户了如指掌,但缺乏向其他团队清晰传递这些知识的机制。
我们需要一种统一的用户认知框架,既要足够宽泛以实现公司级对齐,又要足够深入以支撑具体产品开发。同时实现广度与深度,看似难以兼顾。
为何要超越传统人物画像
过去,我们发现传统人物画像存在两大典型问题:
- 过时且难更新:团队完成访谈并制作画像后,便将文档存档,视为已结项任务。当获取新信息时,往往不会回头更新,导致画像一年内便失去准确性。其他团队发现数据失真后,逐渐丧失信任。
- 缺乏实证支撑:大语言模型可以轻松生成看似合理的人物画像(例如“安全工程师”),却缺乏真实依据,甚至强化刻板印象。模型输出的是训练数据的平均化结果,而非我们特定运营人员的真实写照。(在LLM出现之前,这类问题被称为“剪贴人物画像”。)
原型的维护方式应如同产品而非一次性项目。用户描述必须基于最新证据才具有实用价值。我们需要的不是更多文档,而是基于可靠来源的共享词汇体系。
正是基于这一理念,我们将原型与人物画像进行了区分。
什么是原型?
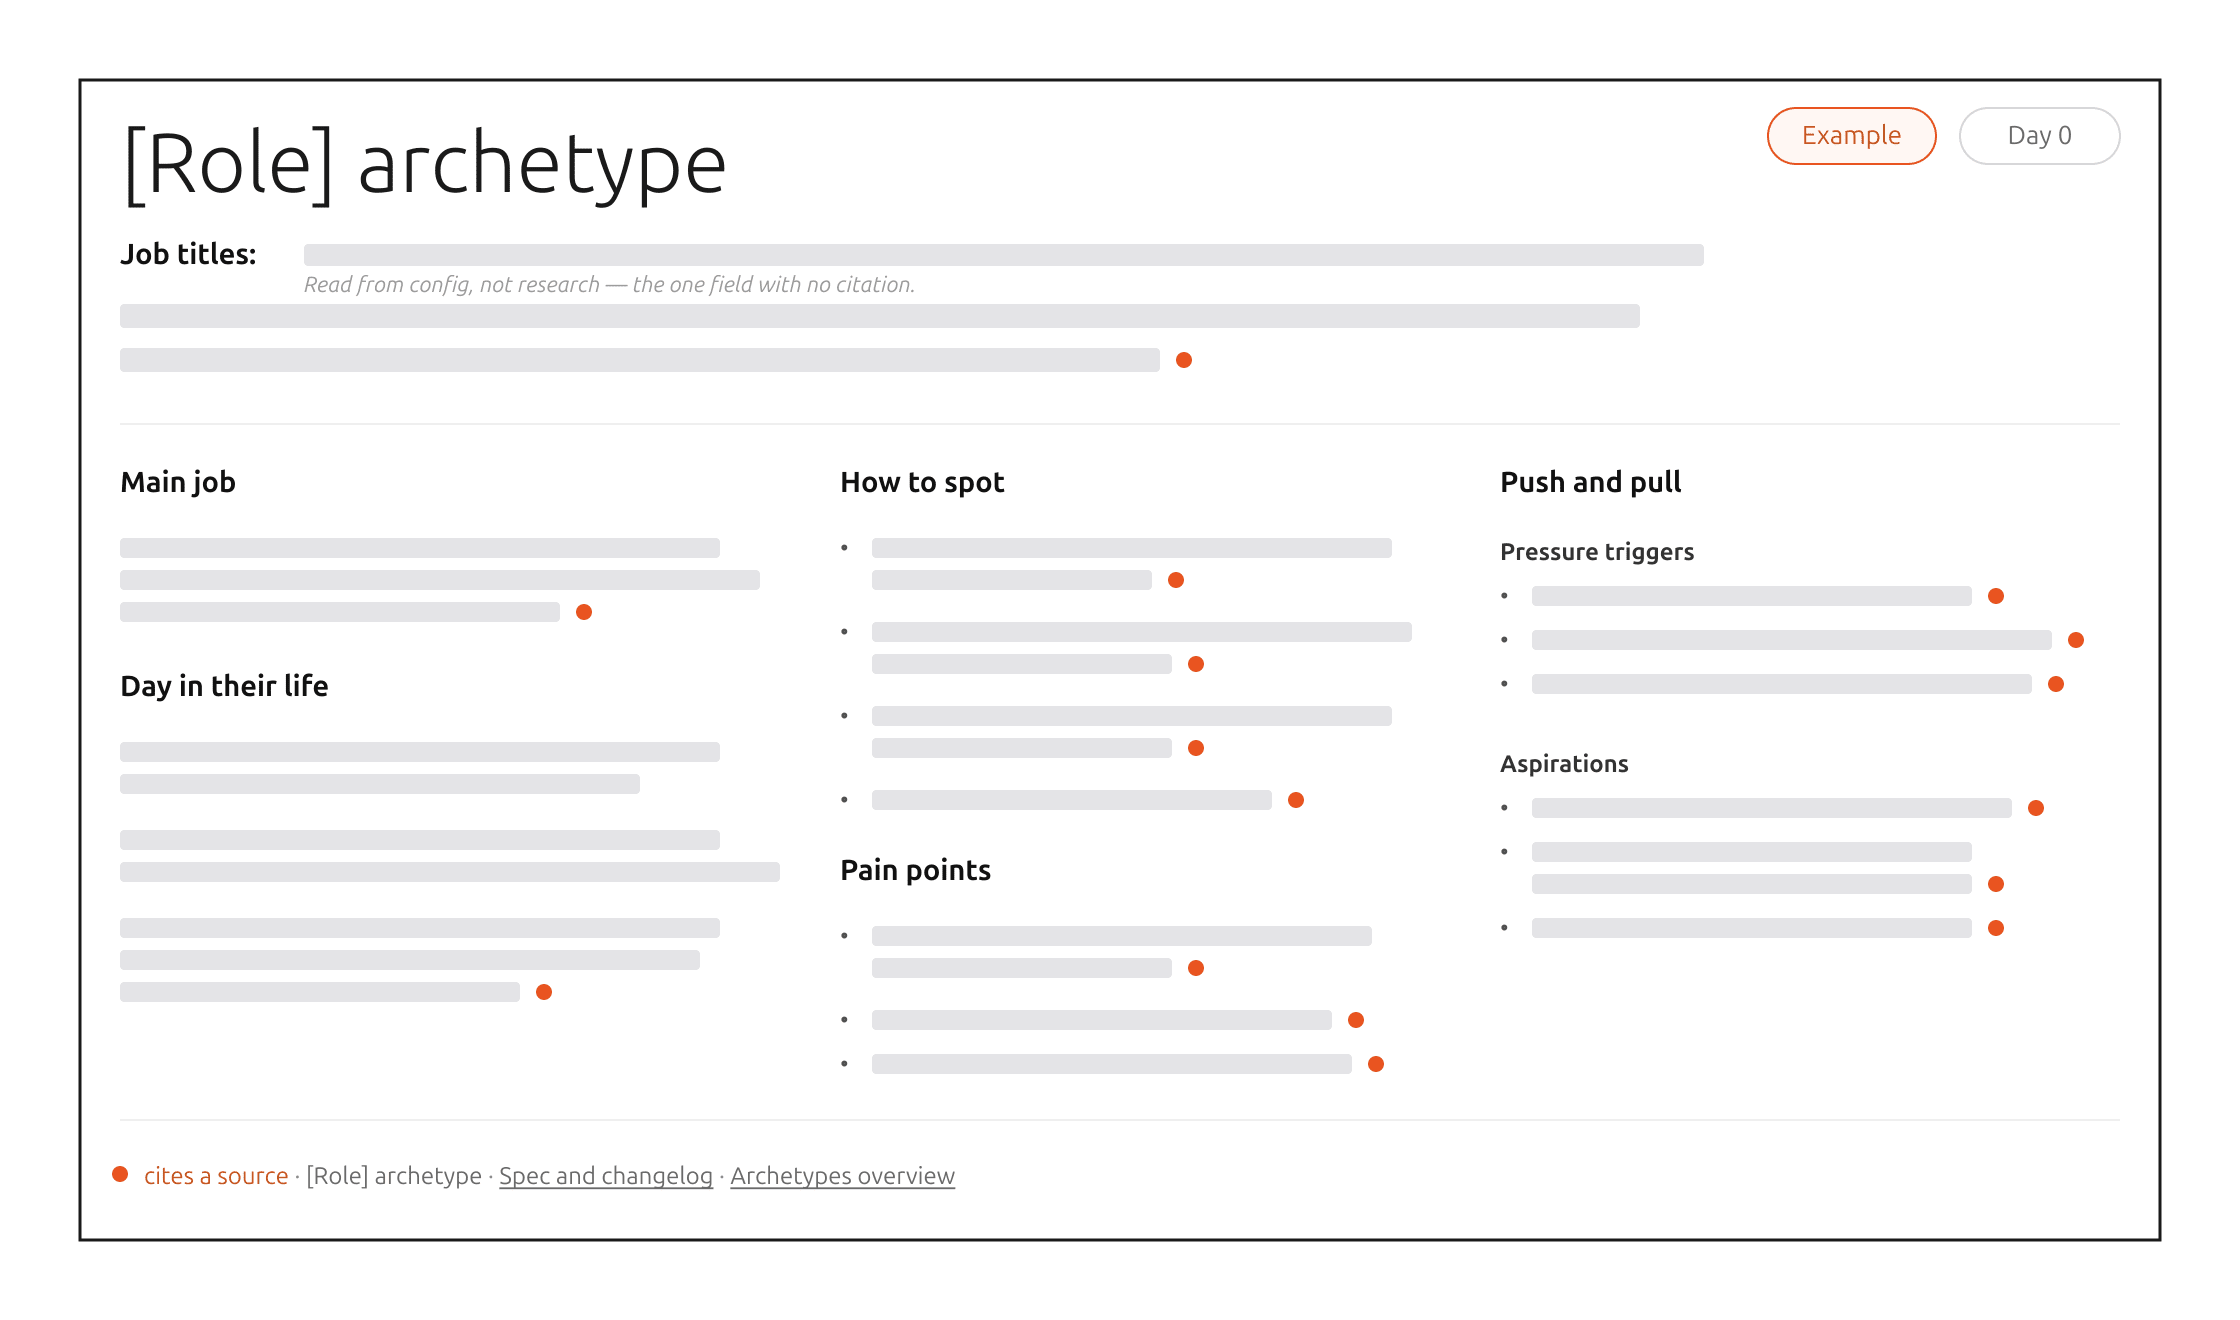
原型描述的是贯穿我们全产品线的用户类型,而非罗列姓名、咖啡偏好或占位照片等表面人口统计学特征。我们聚焦于:用户如何评估新工具、什么会破坏其信任、对他们而言糟糕的一天是怎样的。所有行为描述都能追溯到具体来源(访谈记录、支持论坛帖文、跨多个对话中浮现的规律),因此每一项主张均可核查,而非盲目采信。
原型不属于撰写它的团队,而是适用于我们完整的产品矩阵。我们按照用户在客户旅程中的阶段进行组织(例如:Day 0评估期、Day 1部署期、Day 2运维期),使得十数个为同一基础设施操作员服务的团队能够基于同一份文件开展工作,而非各自重复访谈、得出独立结论。
情境人物画像:另一组成部分
情境人物画像(contextual persona)是这套体系的另一半:团队针对特定产品、功能或发布活动,基于同一用户原型生成的专属视角。它读起来像传统人物画像——有命名、细节、聚焦单一用例,但它是叠加在原型之上,而非孤立存在。
双层架构:广度与深度兼顾
我们通过双层架构同时实现广度与深度:
- 原型层(广度):由用户科学团队集中维护,提供全产品线范围的概览视图。
- 情境人物画像层(深度):由各团队为自己负责的功能或产品发布构建,由使用团队自行拥有。情境人物画像从不从零开始——它们基于原型衍生,继承相同的证据与行为基础。当团队在构建情境画像时发现新信息,这些洞察会反馈回原型,而非滞留于单一团队。
这种设计确保了用户认知的流动与沉淀:底层原型保持新鲜准确,上层情境画像则灵活适配具体产品需求。
关注微信号:智享开源 ,及时了解更新信息。

 扫码关注公众号:智享开源

还没有任何评论,你来说两句吧!